Petit labo LLM local avec une ancienne carte de minage
Test d’inférence IA locale avec une Zotac P102-100 d’occasion : pilotes NVIDIA patchés, Ollama, Qwen Coder et mesures dans un homelab.
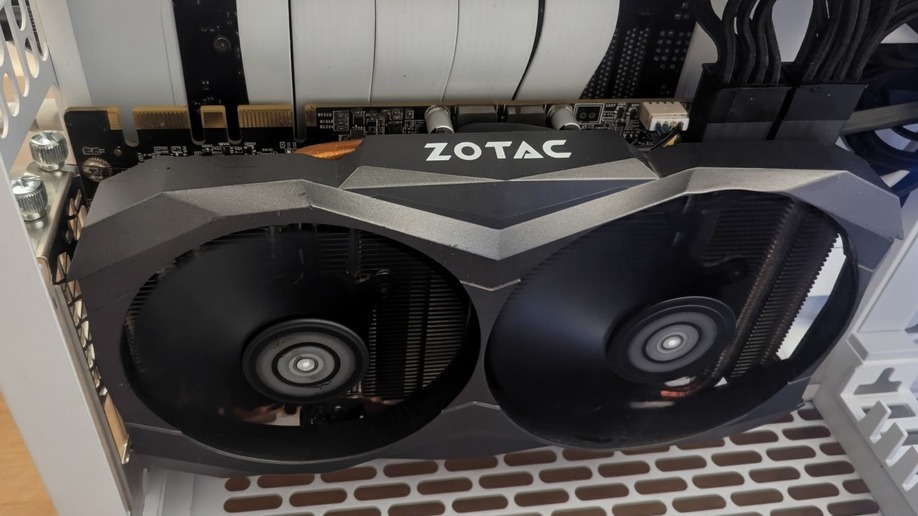
Labo d’inférence IA sur une carte avec un GPU de minage d’occasion
Nouvelle mise à jour : Descendez pour découvrir ce qui se prépare avec une RTX 2080 Ti modifiée dotée de 22 Go de VRAM !
J’ai récemment vu de plus en plus de personnes publier des vidéos sur l’exécution de LLM en local et sur l’infrastructure nécessaire. J’ai aussi découvert le subreddit LocalLLaMA sur Reddit, ce qui m’a donné envie de monter moi-même une petite installation locale.
Mon objectif était de monter une configuration avec une seule carte GPU pour faire des essais d’inférence IA, des mesures de performances et des tests GPU dans mon homelab.
La carte que j’ai achetée est une Zotac P102-100. C’est un GPU de minage de génération Pascal, équivalent à une GTX 1080 de 10 Go, avec une particularité importante : elle ne possède aucune sortie vidéo physique.
Pas de HDMI, pas de DisplayPort, rien. Elle n’a donc vraiment de sens que dans une configuration sans écran.
Ce n’est pas du tout un GPU de jeu. Certaines personnes ont essayé des configurations de jeu sans écran avec des outils comme Parsec pour l’accès à distance et des pilotes personnalisés, et y sont parvenues. C’est techniquement possible, mais difficile, et ce n’est pas mon cas d’usage.
Je l’ai achetée pour voir si elle pouvait servir de carte d’inférence abordable pour l’IA locale.
1. Pourquoi cette carte atypique
Eh bien, eh bien, eh bien : le prix, le défi et la VRAM !
Je n’ai payé que 47 euros sur eBay pour un GPU doté de 10 Go de VRAM. Pour faire des essais d’IA, c’est une quantité de mémoire intéressante pour ce prix.
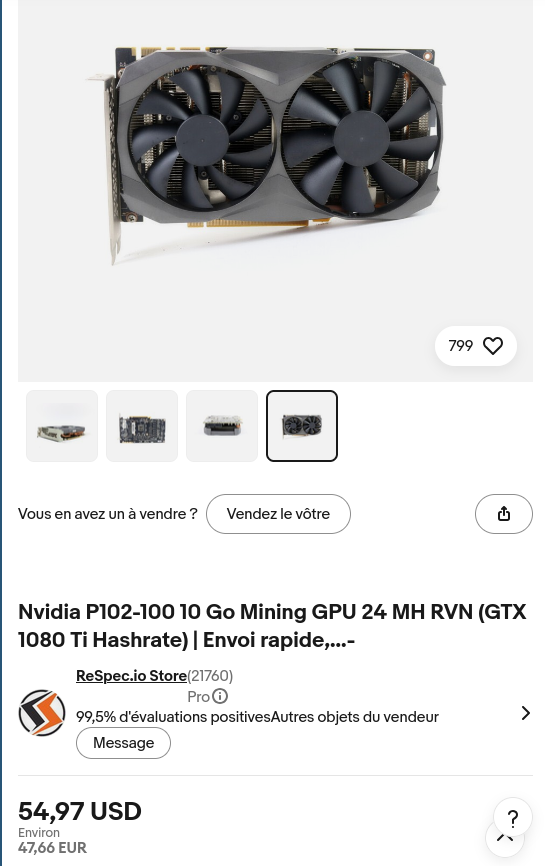
Photo de l’annonce eBay de la Zotac P102-100
La carte est répertoriée ici sur TechPowerUp :
https://www.techpowerup.com/gpu-specs/zotac-p102-100.b5306
Je suis aussi tombé sur cette vidéo de Compelling Bytes :
https://www.youtube.com/watch?v=6TnUwsxziD4&t=1s
La vidéo s’intitule « Dirt Cheap Local AI… » et m’a donné un point de comparaison utile pour cette carte. La configuration présentée utilisait une P102-100 avec Qwen 2.5 7B Instruct, une quantification sur 6 bits, un conteneur avec le backend CUDA de llama.cpp et un corpus documentaire pour le RAG contenant 186 000 segments issus de neuf projets. Je n’en suis pas encore au RAG ni aux essais de quantification : j’ai simplement déployé la configuration sur mon deuxième nœud Proxmox pour un test de bon fonctionnement.
Mon objectif n’était pas de reproduire à l’identique cette configuration RAG. Je voulais voir si un LLM local peu coûteux pouvait être utile dans mon propre homelab, et s’il serait intéressant d’investir plus tard dans une carte graphique plus puissante si le flux de travail s’avérait utile, facile à maintenir et peut-être ajustable finement.
Les compromis sont évidents. Elle est ancienne, basée sur Pascal, dépourvue de sortie vidéo et n’a jamais été conçue comme une carte grand public agréable à utiliser.
Pour une VM ou un serveur sans écran, l’absence de sortie vidéo n’est pas vraiment un problème.
Pour cette configuration, l’accès à nvidia-smi comptait davantage que la sortie vidéo :
Et il fallait aussi vérifier qu’une charge d’inférence pouvait réellement s’exécuter sur le GPU au lieu de basculer discrètement sur le CPU.
2. Environnement de test
Il ne s’agissait pas d’un examen complet des performances, mais d’un test de compatibilité et d’utilisation pour l’inférence locale à petit prix.
Voici la configuration du test de bon fonctionnement :
1
2
3
4
5
6
7
8
a Debian 13 Proxmox VM, 24 GB of RAM, 8 CPU
Kernel: 6.12.90+deb13.1-amd64

NVIDIA driver: 580.159.04 -> more later

Ollama version: 0.30.7
Model: qwen2.5-coder:7b
Quantization: Q4_K - Medium
J’ai aussi commencé par tester la version du pilote NVIDIA 550 fournie par Debian, mais cela s’est révélé être le principal bémol de l’expérience.
3. Premier objectif : faire reconnaître correctement la carte par Linux
Avant de tester Ollama ou des modèles, je devais faire fonctionner la pile de pilotes.
La carte apparaît comme une P102-100, mais ces cartes de minage ont quelques particularités. Une installation standard du pilote NVIDIA ne suffit pas toujours, car la carte a besoin d’un pilote patché pour être correctement reconnue en tant que GPU de calcul.
Voici donc la liste de vérifications de base :
1
2
3
lspci -nnk | grep -A4 -Ei 'nvidia'
lsmod | grep -E 'nvidia|nouveau'
nvidia-smi
Il faut aussi surveiller l’intervention de Nouveau. Si Nouveau prend d’abord en charge la carte, le pilote NVIDIA échoue généralement ou se comporte de manière déroutante.
J’ai dû mettre le pilote nouveau sur liste noire et passer à un correctif dédié à ces cartes, présenté juste après.
4. Patch du pilote
Pour cette carte, j’ai utilisé le projet de patch NVIDIA :
Les instructions pour Linux suivent une procédure de patch du fichier run plutôt que d’utiliser les paquets Debian.
La procédure était la suivante :
1
2
3
4
./NVIDIA-Linux-x86_64-580.159.04.run --extract-only
./linux.sh
cd NVIDIA-Linux-x86_64-580.159.04
sudo ./nvidia-installer
Le correctif modifie le binaire du pilote NVIDIA avant que le programme d’installation ne compile et installe le module du noyau.
C’est le principal inconvénient en matière de maintenance par rapport aux pilotes NVIDIA fournis par la distribution. J’apprécie les systèmes gérés par paquets et je ne suis pas fan des pilotes installés avec un fichier run. Mais pour cette carte précise, la méthode de patch prise en charge comptait davantage que le fait de la traiter comme un GPU grand public standard.
J’ai aussi testé l’ancienne version du pilote NVIDIA fournie par Debian. Elle était plus propre du point de vue de la maintenance du système, et nvidia-smi fonctionnait après le patch, mais Ollama ne la gérait pas bien avec CUDA.
Le journal était assez explicite :
1
2
NVIDIA driver too old
required_driver="570 or newer"
Avec l’ancien pilote 550, Ollama détectait toujours la carte, mais utilisait le backend Vulkan au lieu de CUDA. Ce n’était pas du tout ce que je voulais pour cette configuration.
Avec le pilote 580.159.04 patché, Ollama a sélectionné CUDA.
5. Ollama et Qwen Coder
Le test portait sur Ollama avec un modèle de génération de code Qwen.
J’ai utilisé :
1
ollama pull qwen2.5-coder:7b
Ce modèle convient bien à une carte de ce type : il est assez utile pour tester des requêtes de programmation, tout en étant suffisamment petit pour tenir facilement dans les 10 Go de VRAM.
La requête de test était une petite tâche de programmation :
1
Write a complete Python 3 program that reads an nginx access log from stdin and prints the top 10 client IP addresses by request count.
C’était un test de bon fonctionnement, pas une mesure contrôlée des performances. L’objectif était de confirmer que le modèle se chargeait, utilisait CUDA, occupait de la VRAM et maintenait le GPU en activité pendant la génération.
Voici les points vérifiés :
- Ollama détecte-t-il le GPU ?
- L’utilisation de la VRAM augmente-t-elle ?
- L’utilisation du GPU augmente-t-elle ?
- Le modèle termine-t-il son exécution sans planter ?
- Les journaux indiquent-ils l’utilisation de CUDA/NVIDIA plutôt que du CPU seul ?
6. nvtop
J’ai aussi installé nvtop, un nouvel outil que j’ai dû utiliser pour voir comment la carte graphique gérait le test.
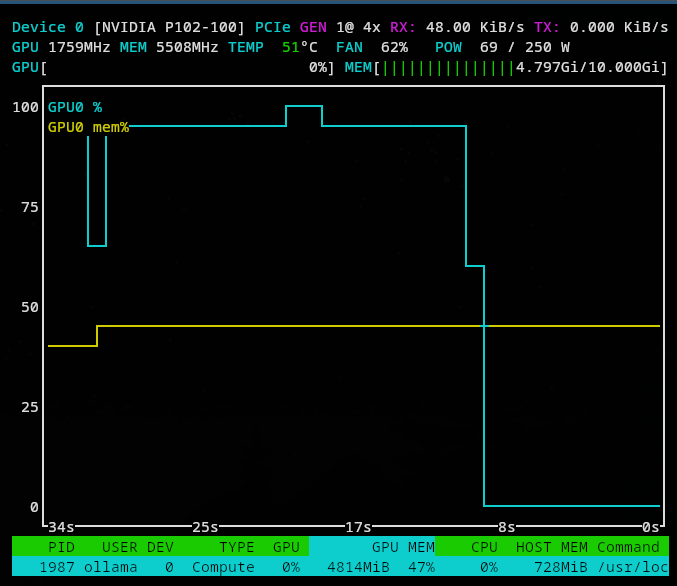
nvtop est agréable et familier, comme htop, pour surveiller la carte en direct pendant l’exécution du modèle.
1
nvtop
Il affiche l’utilisation de la mémoire, le taux d’utilisation, la puissance et le processus qui utilise le GPU.
7. Ce qui a fonctionné
Le meilleur résultat, sans faire durer le suspense, a été obtenu avec le pilote NVIDIA 580 patché.
Ollama a détecté que la carte était compatible avec CUDA, a chargé le modèle sur le GPU et l’a exécuté en faisant réellement travailler la carte.
nvidia-smi a confirmé que le pilote NVIDIA voyait la carte :
Les journaux d’Ollama étaient plus importants, car ils confirmaient que le programme d’exécution du modèle avait sélectionné CUDA0 au lieu de basculer sur le CPU ou Vulkan :
1
journalctl -u ollama -n 200 --no-pager
La ligne utile était :
1
using device CUDA0 (NVIDIA P102-100)
C’est ce qui distingue « le pilote est présent » de « la charge de travail utilise réellement la carte ».
8. Quelques chiffres
Avec qwen2.5-coder:7b, la carte a utilisé environ 4,8 Go de VRAM pendant l’exécution. La valeur maximale que j’ai relevée était de 4817 MiB.
Quelques valeurs relevées avec nvidia-smi pendant l’exécution :
1
2
3
4
5
Idle / no workload power seen: around 55 W
Peak power observed: around 259 W
Peak temperature observed: 61 C
Peak GPU utilization observed: 100 %
Peak VRAM used: 4817 MiB / 10240 MiB
Les trois essais ont donné les résultats suivants :
1
2
3
Run 1: 57.99s
Run 2: 24.66s
Run 3: 28.69s
Le premier essai était plus lent à cause du démarrage à froid et du chargement du modèle. Les deuxième et troisième essais sont plus représentatifs.
Pour mon essai de référence, Ollama a indiqué 35.65 tokens/s pendant la génération. J’ai aussi vu des journaux du programme d’exécution Ollama autour de 47 à 50 tokens/s lors d’un autre essai mesuré ; je considère donc ces chiffres comme des vérifications préliminaires plutôt que comme un benchmark définitif.
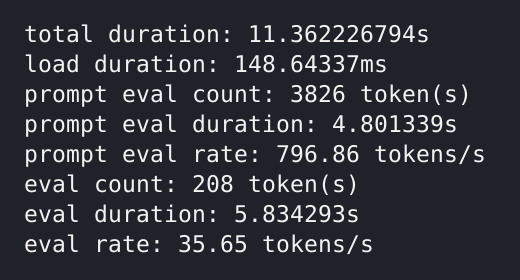
Ce résultat n’est pas comparable à celui du matériel d’inférence moderne, mais pour une carte à 47 euros avec 10 Go de VRAM, c’est suffisant pour valider un concept dans un homelab.
Je voudrais tout de même effectuer plus tard une session de mesure plus rigoureuse, avec un ensemble de requêtes fixe et une phase de chauffe mieux contrôlée. Ce premier test visait surtout à confirmer que le modèle se chargeait et utilisait CUDA.
9. Maintenance du pilote
La principale difficulté concerne la maintenance du pilote.
Une installation classique du paquet NVIDIA de Debian est bien plus facile à maintenir, mais avec cette carte, ce n’était pas la voie la plus directe. Le pilote installé avec un fichier run est plus difficile à maintenir, car il échappe au fonctionnement normal du gestionnaire de paquets.
Les mises à jour du noyau demandent aussi de l’attention. DKMS peut recompiler le module, mais cela reste moins prévisible qu’avec un GPU grand public entièrement pris en charge et un paquet standard de la distribution.
La limite évidente est qu’il s’agit d’une ancienne carte Pascal. Elle est utile pour tester de petits modèles quantifiés, mais il ne faut pas la comparer aux cartes RTX modernes en matière de performances, d’efficacité ou de prise en charge logicielle.
Le compromis est donc clair :
- Carte de 10 Go peu coûteuse
- Suffisante pour tester l’inférence sur une seule carte
- Aucune sortie vidéo, ce qui convient à un usage serveur
- Davantage de travail sur les pilotes qu’avec un GPU standard
- Architecture Pascal ancienne
- Je ne la recommanderais pas pour un ordinateur de bureau silencieux, prêt à l’emploi
10. Conclusion
Cette carte est utile pour les tests, mais limitée par son âge, son architecture Pascal et la maintenance du pilote. Elle me permet de tester à moindre coût le passthrough GPU, les pilotes NVIDIA, Ollama, Qwen Coder et des outils de surveillance, sans acheter une carte beaucoup plus chère.
J’ai moins de scrupules à utiliser cette carte pour mes expériences. C’est essentiellement du matériel électronique en fin de vie : elle ne sert plus aux jeux ordinaires, elle est trop ancienne pour être intéressante en minage et elle est assez particulière pour que la plupart des gens passent leur chemin.
Pour un prototype d’IA dans un homelab, c’est justement ce qui la rend intéressante.
J’ajouterai probablement des mises à jour à cet article de temps en temps. Il y a encore beaucoup de choses que je veux essayer, comme l’utiliser comme agent depuis VS Code et peut-être ajouter une interface Web avec un outil comme Open WebUI.
Je ne recommanderais ce type de carte qu’aux personnes à l’aise avec les pilotes patchés, les configurations Linux sans écran et la maintenance occasionnelle après les mises à jour du noyau ou du pilote.
Pour une machine d’IA prête à l’emploi, une carte RTX standard est un choix plus sûr.
Mise à jour de juillet 2026
J’ai récemment reçu une NVIDIA RTX 2080 Ti modifiée avec 22 Go de VRAM au lieu des 11 Go d’origine. Elle a été plus compliquée à obtenir : j’ai dû payer en cryptomonnaie sans véritable garantie que la carte arriverait ou fonctionnerait. Elle est toutefois là et fonctionne très bien, pour le moment :)
Contrairement à la P102-100, cette carte possède aussi des sorties vidéo, ce qui la rend bien plus pratique au quotidien ; elle coûte également six fois plus cher que la carte précédente et reste difficile à trouver.
Les premiers résultats sont plutôt bons. Avec qwen2.5-coder:7b, la RTX 2080 Ti a atteint une moyenne d’environ 98 tokens/s. C’est presque trois fois plus rapide que le premier résultat de la P102-100 et environ deux fois plus rapide que ses meilleurs essais.
J’ai aussi essayé Devstral Small 2 24B Q5_K_M. Il a atteint une moyenne d’environ 31 tokens/s et utilisé environ 17.5 GB de VRAM, en tenant entièrement dans la VRAM du GPU. J’ai également remplacé l’ancien pilote 580 patché par le pilote original le plus récent.
Je suis vraiment ravi que les 22 GB de VRAM soient détectés et fonctionnent si bien.
J’espère avoir suffisamment de temps pour poursuivre ces essais, réaliser une intégration complète avec l’agent de programmation Pi et tester aussi un autre moteur d’inférence.